En un artículo sobre voces queer y transgénero, los autores informan de que las valoraciones humanas hallaron que 2 de los 6 modelos TTS zero-shot sintetizan voces de género expansivo (GE) menos similares que las voces de género no expansivo (N-GE), mientras que 3 mejoran su rendimiento con las voces GE (arXiv). Las métricas automáticas dieron resultados contradictorios, según los autores. Para quienes dependen de puntuaciones automáticas para elegir o validar un modelo de clonación de voz, la segunda pregunta de investigación, sobre si los algoritmos de evaluación están sesgados en comparación con las medidas basadas en oyentes, es la que influye en esa decisión (arXiv).
Qué se probó en el estudio
Los autores evalúan seis modelos TTS zero-shot en dos conjuntos de datos. Un conjunto contiene voces de género no expansivo (N-GE) y el otro contiene voces de género expansivo (GE) de hablantes que se autoidentifican como tales. Los sistemas zero-shot clonan una voz a partir de una muestra de referencia breve, así que la forma de construir cada referencia condiciona todo lo que sigue.
Según el artículo, se creó una muestra de referencia para los 14 hablantes de MAGES y los 14 de GLOBE. Aquí los hablantes de MAGES son el grupo GE y los de GLOBE son el grupo N-GE. Por tanto, la comparación se apoya en dos grupos de hablantes del mismo tamaño. Con grupos de ese tamaño, cada hablante individual pesa mucho, lo cual es una razón para leer los contrastes por modelo que siguen como indicios para estos hablantes y no como reglas universales.
Las valoraciones humanas se dividen según el modelo
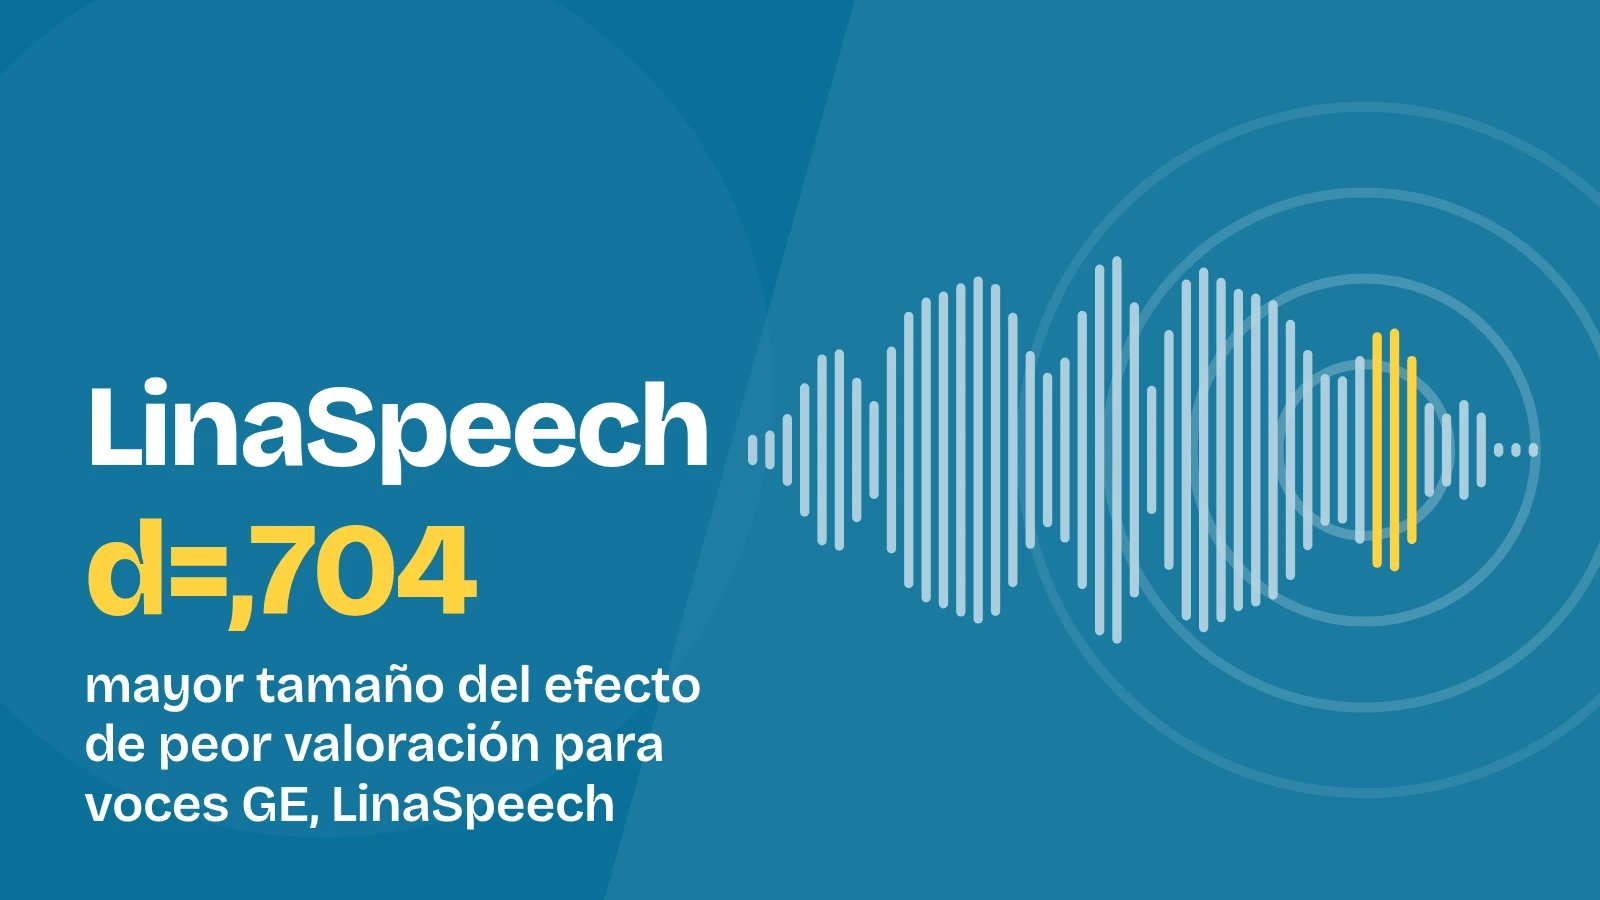
Las métricas subjetivas variaron entre modelos: dos modelos mostraron peor rendimiento con hablantes GE y tres mostraron mejor rendimiento. El mayor tamaño del efecto en los casos en que las voces GE salieron peor correspondió a LinaSpeech (d=,704), seguido de XTTS (d=,419). Esos dos modelos son los que explican el resultado desfavorable a las voces GE en las valoraciones humanas. La división importa porque un único promedio de los seis sistemas difuminaría una desventaja real para las voces GE en algunos modelos con una ventaja en otros.
La prueba de la tasa de error de palabras (WER) apunta en el mismo sentido para un modelo. Solo aparecieron diferencias significativas de WER en LinaSpeech, con una WER más alta en las salidas GE. F5TTS rozó la significación con p=,051. Por tanto, la inteligibilidad y la similitud percibida coinciden en LinaSpeech, lo que lo convierte en el caso más claro de peor servicio a las voces GE en este artículo.
Las métricas automáticas discrepan
Para el modelo ZONOS, las tres métricas de similitud de hablante no coinciden sobre qué conjunto de datos rinde mejor. ECAPA-TDNN predice un mejor rendimiento para las voces GE y TitaNet-L predice un mejor rendimiento para las voces N-GE. ReDimNet-M no encontró diferencias entre los conjuntos de datos. Un equipo que eligiera un solo modelo de embeddings para puntuar ZONOS llegaría a una conclusión distinta según su elección.
UTMOS, un predictor de puntuaciones de calidad, predijo puntuaciones AMOS significativamente más altas para las voces N-GE en todos los modelos. Ese resultado va en contra de las valoraciones humanas, en las que tres modelos rindieron mejor con voces GE. Un predictor de calidad que favorece las voces N-GE en todos los modelos ocultaría los modelos cuyos resultados valorados por humanos favorecen las voces GE.
Qué implica para la evaluación
Los hallazgos abarcan seis modelos zero-shot y a los hablantes de los dos conjuntos de datos, de modo que describen esos sistemas y esos grupos. Los autores señalan que las métricas automáticas dieron resultados contradictorios, por lo que ninguna puntuación automática puede considerarse un sustituto de las valoraciones de oyentes. La lectura práctica es que evaluar un modelo TTS zero-shot con voces GE exige valoraciones de oyentes junto con puntuaciones de embeddings de hablante y de predictores de calidad, y que los resultados modelo por modelo importan más que un veredicto para toda la familia.
No consta en las fuentes: precio
Comprobamos seis datos en cada historia en el texto completo de cada fuente. Las páginas de la lista de fuentes no indican un precio.
Fuentes
Las fuentes a partir de las que se escribió este artículo. Los enlaces abren la página original.