In un articolo su voci queer e transgender, gli autori riferiscono che le valutazioni umane hanno rilevato che 2 dei 6 modelli TTS zero-shot sintetizzano voci di genere espansivo (GE) meno simili rispetto a quelle non di genere espansivo (N-GE), mentre 3 mostrano prestazioni migliori per le voci GE (arXiv). Secondo gli autori, le metriche automatiche hanno dato risultati contrastanti. Per i professionisti che si affidano a punteggi automatici per scegliere o validare un modello di clonazione vocale, la seconda domanda di ricerca, cioè se gli algoritmi di valutazione siano distorti rispetto alle misure basate sugli ascoltatori, è quella che incide su tale scelta (arXiv).
Che cosa ha verificato lo studio
Gli autori valutano sei modelli TTS zero-shot su due dataset. Un dataset contiene voci non di genere espansivo (N-GE) e l’altro contiene voci di genere espansivo (GE) di parlanti che si autoidentificano come tali. I sistemi zero-shot clonano una voce a partire da un breve campione di riferimento, quindi il modo in cui ogni riferimento viene costruito influenza tutto ciò che segue.
Secondo l’articolo, è stato creato un campione di riferimento per tutti i 14 parlanti di MAGES e i 14 parlanti di GLOBE. Qui i parlanti di MAGES sono il gruppo GE e i parlanti di GLOBE sono il gruppo N-GE. Il confronto si basa quindi su due gruppi di parlanti di uguale dimensione. Gruppi di tali dimensioni fanno pesare molto ogni singolo parlante, e questo è un motivo per leggere i contrasti a livello di modello riportati di seguito come indicazioni per questi parlanti e non come regole universali.
Valutazioni umane divise per modello
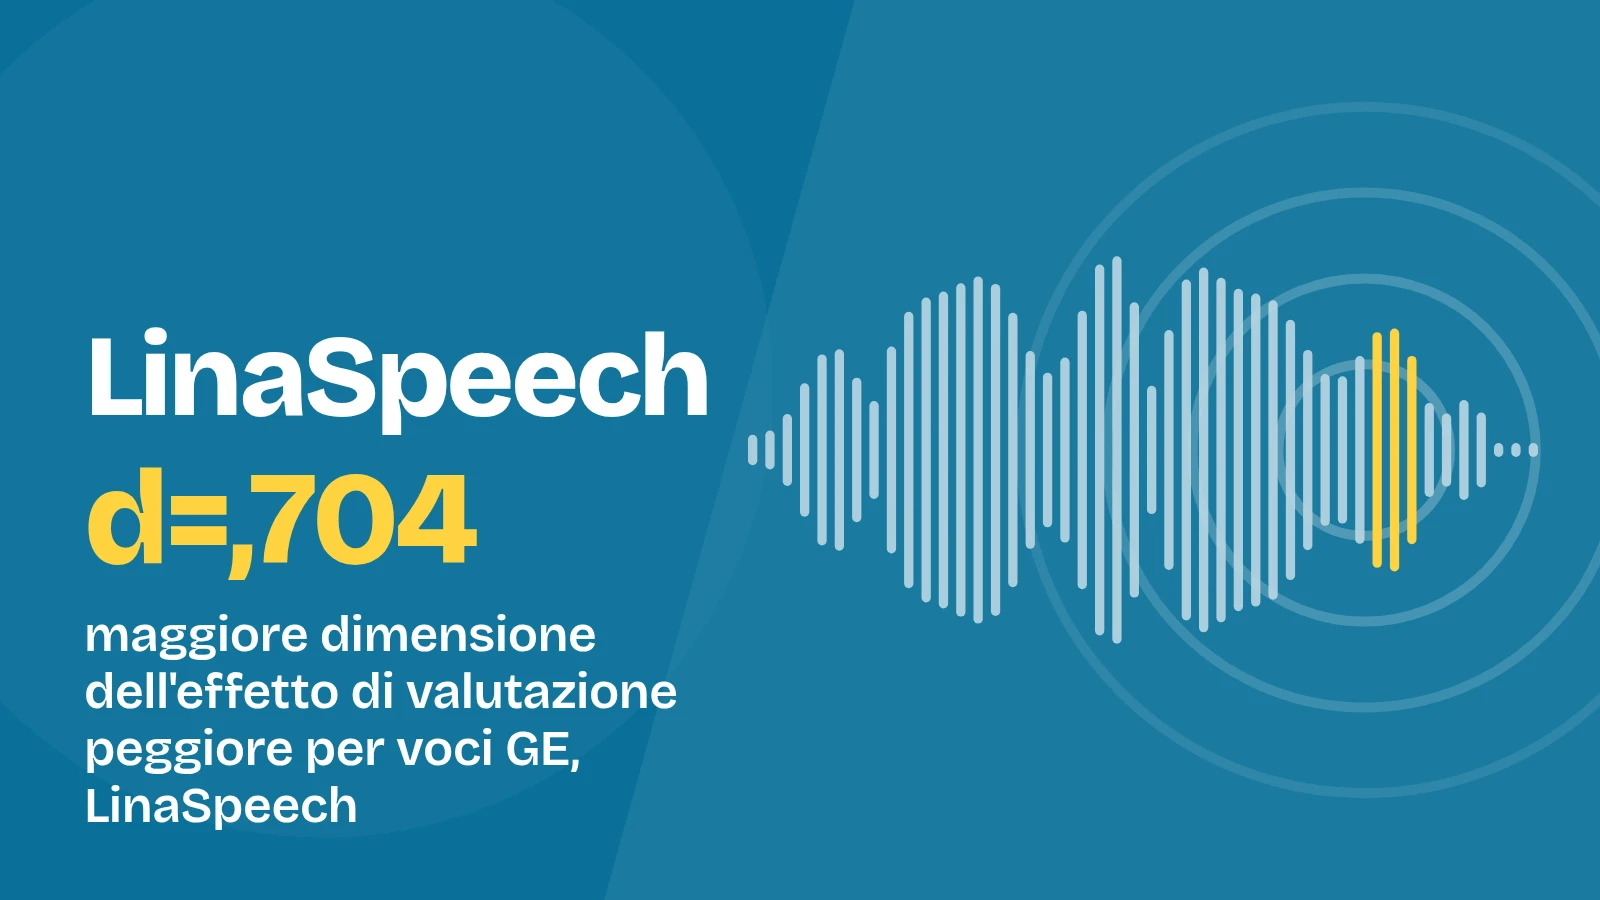
Le metriche soggettive variano da un modello all’altro: due modelli hanno mostrato prestazioni peggiori per i parlanti GE e tre modelli prestazioni migliori. La dimensione dell’effetto maggiore, dove le voci GE hanno ottenuto risultati peggiori, riguarda LinaSpeech (d=,704), seguito da XTTS (d=,419). Questi due modelli sono quelli che spiegano il risultato peggiore per le voci GE nelle valutazioni umane. La divisione è importante perché una singola media su tutti e sei i sistemi offuscherebbe uno svantaggio reale per le voci GE in alcuni modelli, compensato da un vantaggio in altri.
Il test sul tasso di errore sulle parole (WER) va nella stessa direzione per un modello. Differenze significative di WER sono emerse solo per LinaSpeech, con un WER più alto per gli output GE. F5TTS si è avvicinato alla significatività con p=,051. Intelligibilità e somiglianza percepita concordano quindi per LinaSpeech, che diventa il caso più chiaro in questo articolo di servizio peggiore per le voci GE.
Le metriche automatiche non concordano
Per il modello ZONOS, le tre metriche di somiglianza del parlante non concordano su quale dataset ottenga risultati migliori. ECAPA-TDNN prevede prestazioni migliori per le voci GE, mentre TitaNet-L prevede prestazioni migliori per le voci N-GE. ReDimNet-M non ha rilevato alcuna differenza tra i dataset. Un team che scegliesse un solo modello di embedding per valutare ZONOS arriverebbe a una conclusione diversa a seconda della scelta.
UTMOS, un predittore dei punteggi di qualità, ha previsto punteggi AMOS significativamente più alti per le voci N-GE per tutti i modelli. Questo risultato va contro le valutazioni umane, in cui tre modelli hanno ottenuto risultati migliori per le voci GE. Un predittore di qualità che favorisce le voci N-GE in ogni modello nasconderebbe i modelli i cui risultati valutati dagli umani favoriscono le voci GE.
Che cosa significa per la valutazione
I risultati riguardano sei modelli zero-shot e i parlanti dei due dataset, quindi descrivono quei sistemi e quei gruppi. Gli autori riferiscono che le metriche automatiche hanno dato risultati contrastanti, per cui nessun singolo punteggio automatico può essere considerato un sostituto delle valutazioni degli ascoltatori. La lettura pratica è che valutare un modello TTS zero-shot sulle voci GE richiede valutazioni degli ascoltatori accanto ai punteggi di embedding del parlante e dei predittori di qualità, e che i risultati per singolo modello contano più di un verdetto valido per l’intera famiglia.
Assente dalle fonti: prezzo
Controlliamo sei dati in ogni storia nel testo completo di ogni fonte. Le pagine elencate tra le fonti non indicano un prezzo.
Fonti
Le fonti da cui è stato scritto questo articolo. I link aprono la pagina originale.